
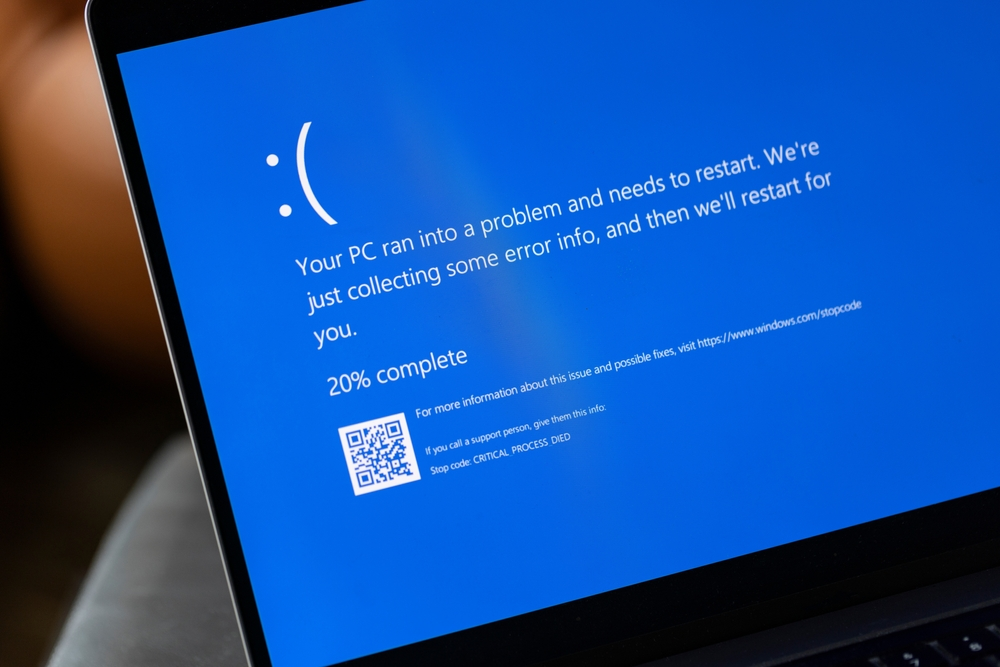
Em julho de 2024, uma única atualização defeituosa no arquivo de configuração do sensor Falcon da CrowdStrike derrubou 8,5 milhões de dispositivos ao redor do mundo.
O maior evento de vendor lock-in da história da tecnologia da informação recente não foi causada por um ataque hacker, foi causada pela concentração de confiança em um único fornecedor.
19 de julho de 2024, o dia que o mundo parou
Na madrugada de uma sexta-feira, enquanto analista de segurança ao redor do mundo dormiam, uma atualização defeituosa da CrowdStrike causou o travamento instantâneo de mais de 8 milhões de dispositivos Windows globalmente, gerando a infame “Tela Azul da Morte” (BSOD).
Não era um ataque. Era pior: era uma falha de atualização silenciosa, automatizada e irreversível sem intervenção manual.
Sem chance de correção automatizada, cada máquina afetada precisou ser reiniciada individualmente em modo de segurança para remoção manual do arquivo corrompido, um processo que, em ambientes corporativos com centenas ou milhares de endpoints, levou dias para ser concluído.
Segundo o Gartner, o evento superou em impacto simultâneo os maiores ataques coordenados de ransomware da história
Aviões ficaram em solo. Hospitais cancelaram cirurgias não emergenciais. Bolsas de valores registraram instabilidade na abertura. Sistemas bancários de varejo saíram do ar.
O brasil não estava fora da zona de impacto
No Brasil, a resposta foi expressiva. O alcance do incidente foi determinado puramente por quem utilizava a solução com a função de atualização automática ativada.
O reflexo foi imediato em aeroportos administrados pela AENA e pela Infraero, que operaram com lentidão sistêmica nas telas de check-in e embarque.
Grandes instituições financeiras e operadoras de saúde nacionais também enfrentaram paralisias em seus sistemas internos.
Fontes do setor apontaram que ao menos três grandes conglomerados financeiros do país precisaram acionar às pressas seus planos de continuidade de negócios para manter os serviços mínimos no ar.
Provedores de Serviços Gerenciados (MSPs) que ofertavam CrowdStrike como solução padrão para toda a sua base de clientes não apenas sofreram o impacto uma vez: sofreram multiplicado pelo número de contratos ativos.
A concentração de risco deixou de ser um problema do cliente final e tornou-se uma crise operacional do prestador de serviço.
A armadilha do Vendor Lock-In em cibersegurança
O conceito de Vendor Lock-In (dependência estratégica e operacional de um fornecedor único) é debatido em tecnologia há décadas.
Em segurança cibernética, entretanto, ele assume uma dimensão adicional e mais perigosa: quando o único fornecedor é precisamente a camada que deveria proteger o ambiente, uma falha nessa camada destroi simultaneamente a proteção e a operação.
No caso CrowdStrike, o Falcon não apenas detectou a ameaça, ele era uma ameaça.
E como estava presente em 8,5 milhões de dispositivos com permissões de kernel, sem nenhuma camada intermediária de controle, a propagação foi instantânea e total.
A Microsoft, em relatório publicado após o incidente, sinalizou que estudava restringir o acesso de softwares de segurança ao kernel do Windows, uma mudança arquitetural que impactaria diretamente o modelo operacional de dezenas de fornecedores.
Mais do que uma decisão técnica, foi o reconhecimento tácito de que o atual ecossistema de segurança de endpoints cria riscos sistêmicos em escala.
Resiliência operacional começa com diversificação de stack
A lição mais importante do apagão CrowdStrike não é que a empresa errou, é que o modelo de concentração total de segurança em um único fornecedor não admite margem de erro.
E nenhum fornecedor, por mais robusto que seja, tem margem de erro zero.
O conceito de resiliência operacional em segurança pressupõe que o ambiente continue funcional mesmo quando uma camada específica falha.
Isso implica não apenas redundância de infraestrutura, mas diversificação da stack de proteção, diferentes fornecedores para diferentes camadas, com controle granular sobre quando e como as atualizações são aplicadas.
De acordo com o relatório Cost of a Data Breach 2024 da IBM, organizações que utilizam automação extensiva de segurança identificam e contêm violações em média 98 dias mais rápido do que aquelas que dependem de processos manuais e economizam, em média, US$ 2,22 milhões por incidente.
A automação não é luxo; é a diferença entre um incidente gerenciável e uma crise corporativa.
A pergunta que todo CISO deveria estar fazendo agora
O incidente CrowdStrike não expôs uma vulnerabilidade técnica específica, ele expôs uma decisão estratégica que dezenas de milhares de empresas tomaram: a de delegar toda a sua capacidade de proteção a uma única plataforma, de um único fornecedor, com atualizações automáticas fora do seu controle.
Para os CISOs, CTOs e gestores de TI brasileiros, a pergunta não é se um novo evento desse tipo pode acontecer.
A probabilidade, dado o grau de consolidação do mercado de cibersegurança em poucos grandes players globais, é de que acontecerá novamente. A pergunta real é: quando acontecer, o seu ambiente sobrevive?
Resiliência não se constrói depois do incidente. Ela se constrói agora, nas decisões de arquitetura, na escolha de fornecedores, no desenho de camadas de proteção que se complementam sem criar dependências sistêmicas, e na preferência por soluções que mantenham o controle operacional onde ele sempre deveria estar: nas mãos de quem opera o ambiente.
O maior risco para uma empresa não é o ataque que ela não previu.
É a falha na proteção que ela não imaginava que pudesse acontecer e para a qual não tinha plano B.
Vigilant AutoXDR: Uma plataforma brasileira, sem dependência de atualização estrangeira
O Vigilant opera como plataforma autoXDR e se integra aos principais firewalls e EDRs do mercado, com automação nativa e sem exigir que você abandone as ferramentas que já possui.
O resultado é uma arquitetura que, por design, elimina a dependência de um único ecossistema tecnológico.
Mais de 50.000 padrões de ataque mapeados, Mean Time to Response inferior a 1 minuto e contenção inicial de ameaças em menos de 3 minutos, não pela velocidade de uma atualização automática de kernel, mas pela inteligência de uma plataforma que detecta comportamento anômalo antes que a cadeia de ataque se consolide.
A sua operação está preparada para o próximo apagão?
Converse com um especialista Vigilant e entenda como construir uma arquitetura de segurança resiliente.


Deixar um comentário